前言
花了两个多礼拜,总算把这件事收尾了。
起因特别小,我想给小孩剪个片子。打开硬盘找素材,翻了半个小时也没搞明白哪段是哪天拍的。目录名一个比一个离谱,00_From_Old_Phone、i-xxxx-xxx、100GOPRO,还有一堆孤零零的日期,你知道它大概是哪天导进来的,但不知道是哪天拍的。
接上那块旧盘的时候我瞄了眼数字,391 GB,22,462 个文件,Finder 滚了两分钟才到底。当时第一反应是”算了别弄了”,第二反应是”现在不弄,以后更弄不动”。
旧盘
最先干的是最没技术含量的活:比 SHA256。4,937 个文件一模一样,删之前一个个验过,腾出 73.9 GB。这段其实挺爽的,纯体力活,看着数字往下掉有成就感。
难受的是剩下那两万多,同一张照片能有三份导出,相册软件留着一堆缩略图,PS 存到一半的中间文件,加上几百个 UUID 命名的碎片,全搅在一起。
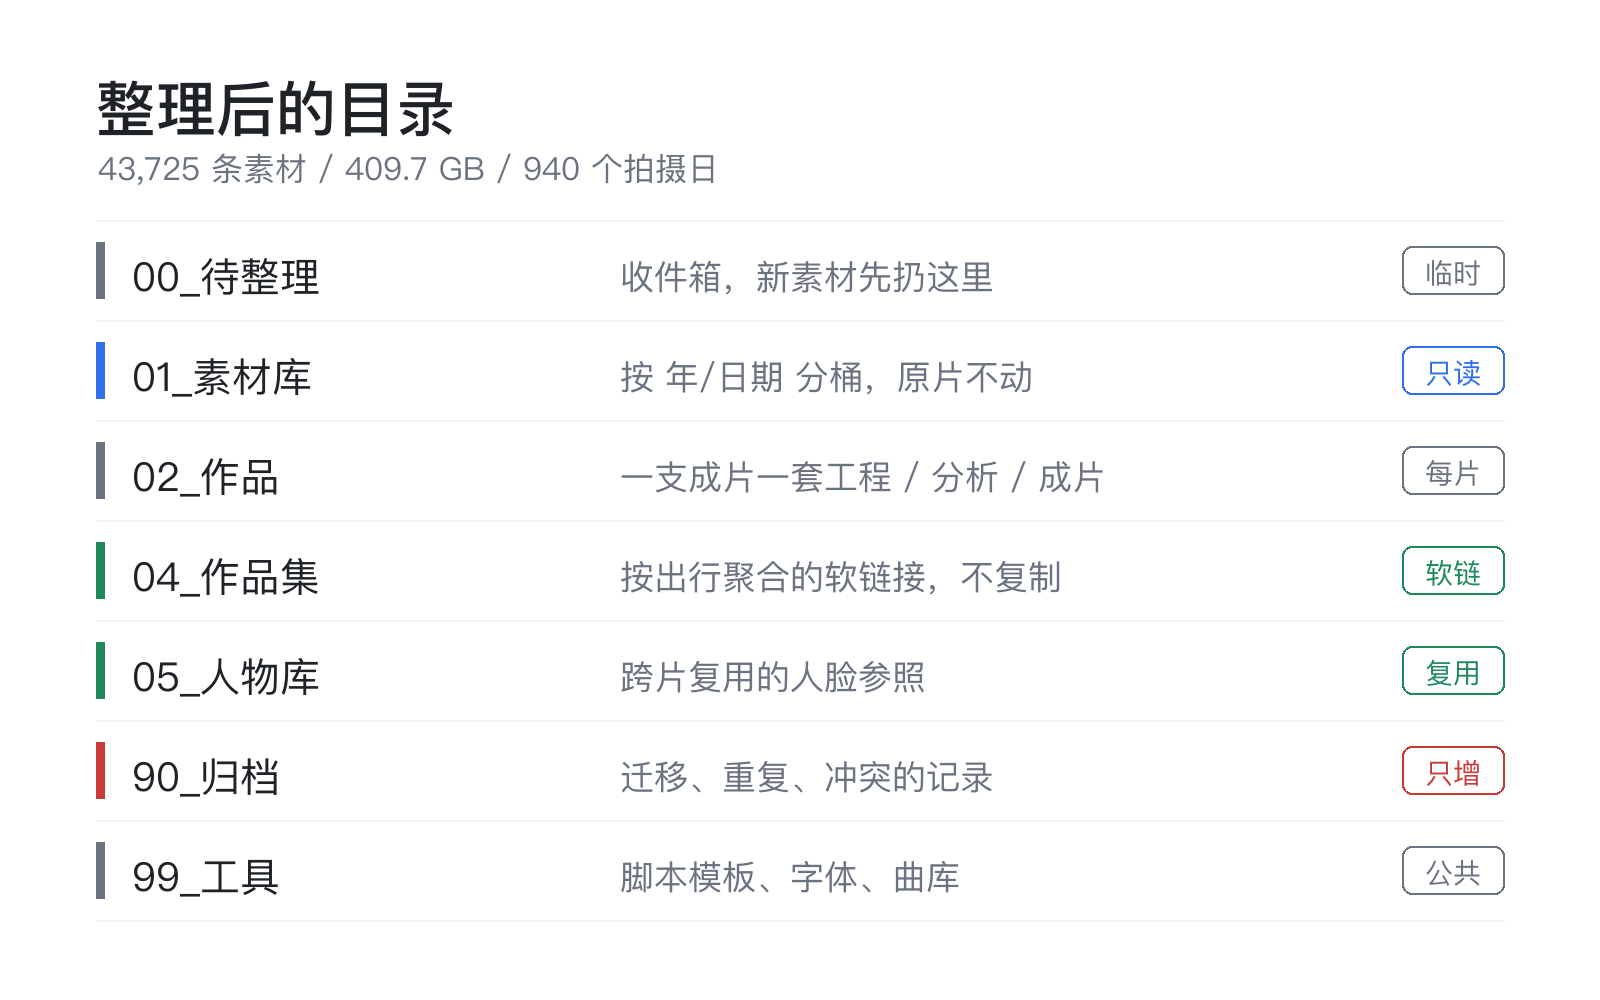
后来我干脆立了条死规矩:素材库只进不改。不改名、不覆盖、不删,新来的先扔收件箱,扫完再 mv 进去。当时只是想图个心安,结果这条救了我好几次,有一次 220 个文件被判成”重复导出”,我一个个验完哈希才敢删,好在确实一模一样,回收 9.47 GB。同一批里还有 7 个同名文件,验下来是不同版本,全留着没动。
最后定下来的目录是这样的:
日期
这些规则后来都写进了 README 和一份整理文档,当时卡住的第一个问题是:一张照片到底该进哪个文件夹。
EXIF 靠不住
理论上 EXIF 里有 DateTimeOriginal,实际上不是每张都有:有一场婚礼,663 张照片,一张都没有。411 张只有 DateTime,那是导出时间;249 张连 EXIF 都没有,只剩个文件夹名;还有 3 张的文件名干脆是另一个年份,相机电池被抠过,时钟归零了。
所以后来定了个七级优先级,从 DateTimeOriginal 一路往后退到文件修改时间。只有前四级能决定目录,后面三级只用来排序,而且必须在表里标清楚是低置信。这个”标清楚”很重要,不然下一次我自己就会把文件夹日期当成 EXIF 用。
|
|
视频和文件名
视频还有一层坑,creation_time 看着最像拍摄时间,但这批素材被批量导入覆盖过,里面装的全是导入那天。现在一律先看 com.apple.quicktime.creationdate,没有才退回文件名;也碰见过一台运动相机整整差了六年半,真实日期反而只留在原始文件名里。
顺手做了一次批量改名,20,658 个原片加 YYYYMMDD_ 前缀,58 个本来就带日期的没动,冲突 0 个。听着简单,改完要同步 11,727 个软链接和 74 处文档引用,这种事只能脚本化,手改必出错。
判重
只靠 SHA256 会漏,重导出会改掉容器里的元数据,同一段视频重压一遍,哈希全变。有次收件箱 2,077 个文件,其中 210 个是已经入过库的重复视频,SHA256 一个都对不上,最后靠视频流哈希才认出来,容器不一样但流一样,就算重。
|
|
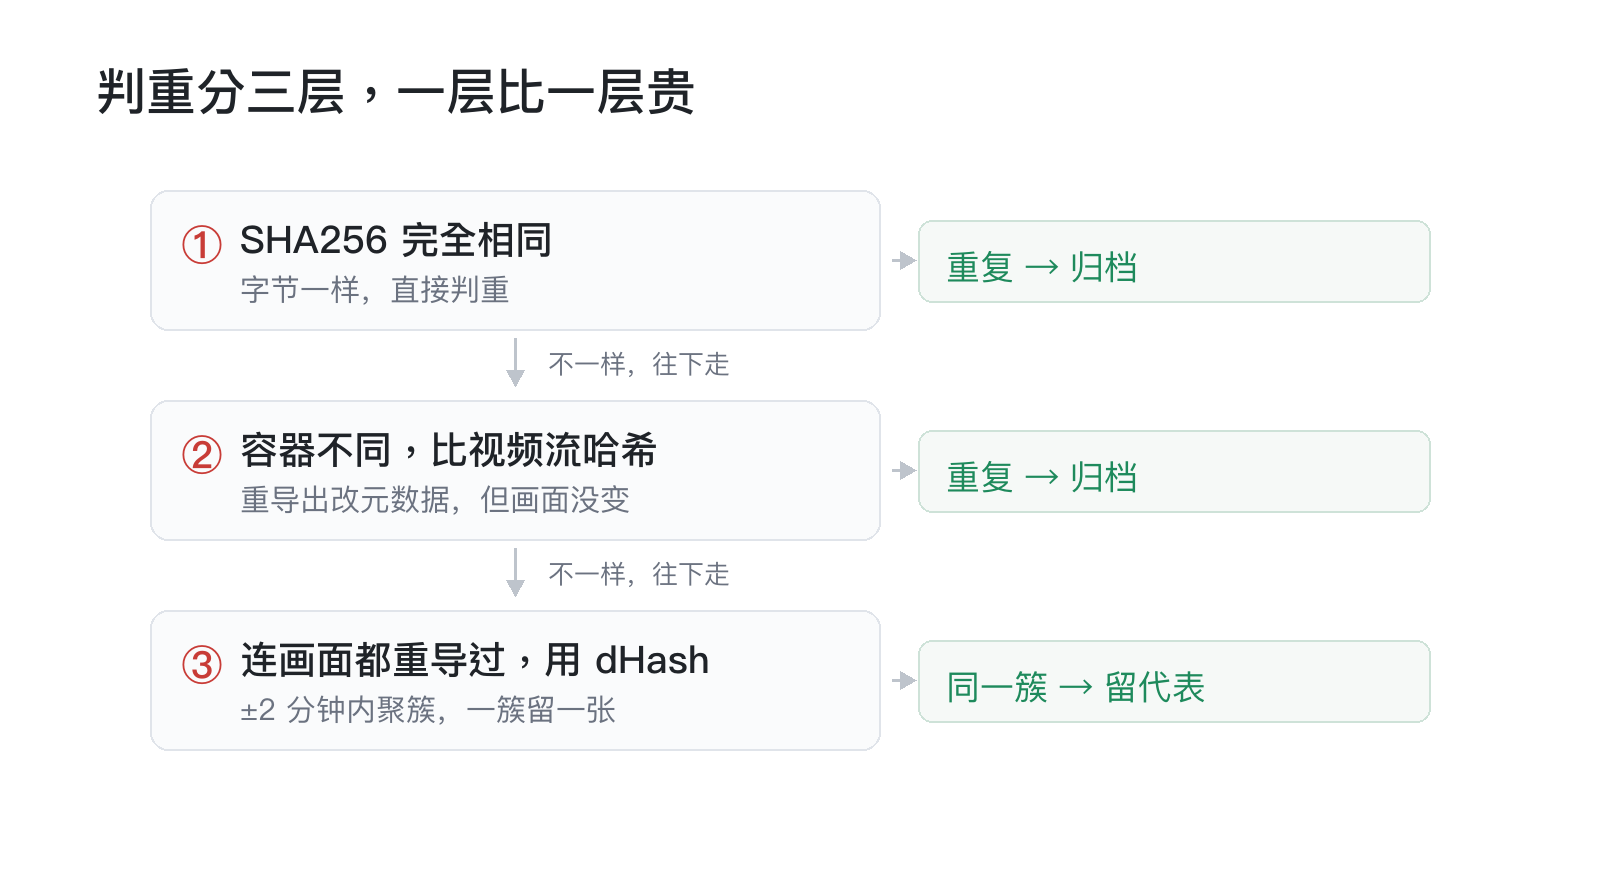
还有一类特别烦,同一天、同一个主文件名,只差后缀大小写,IMG_1234.jpg 和 IMG_1234.jpeg。全库扫出来 3,135 组,每组留字节大的那个,另一份进归档,回收 5.6 GB。
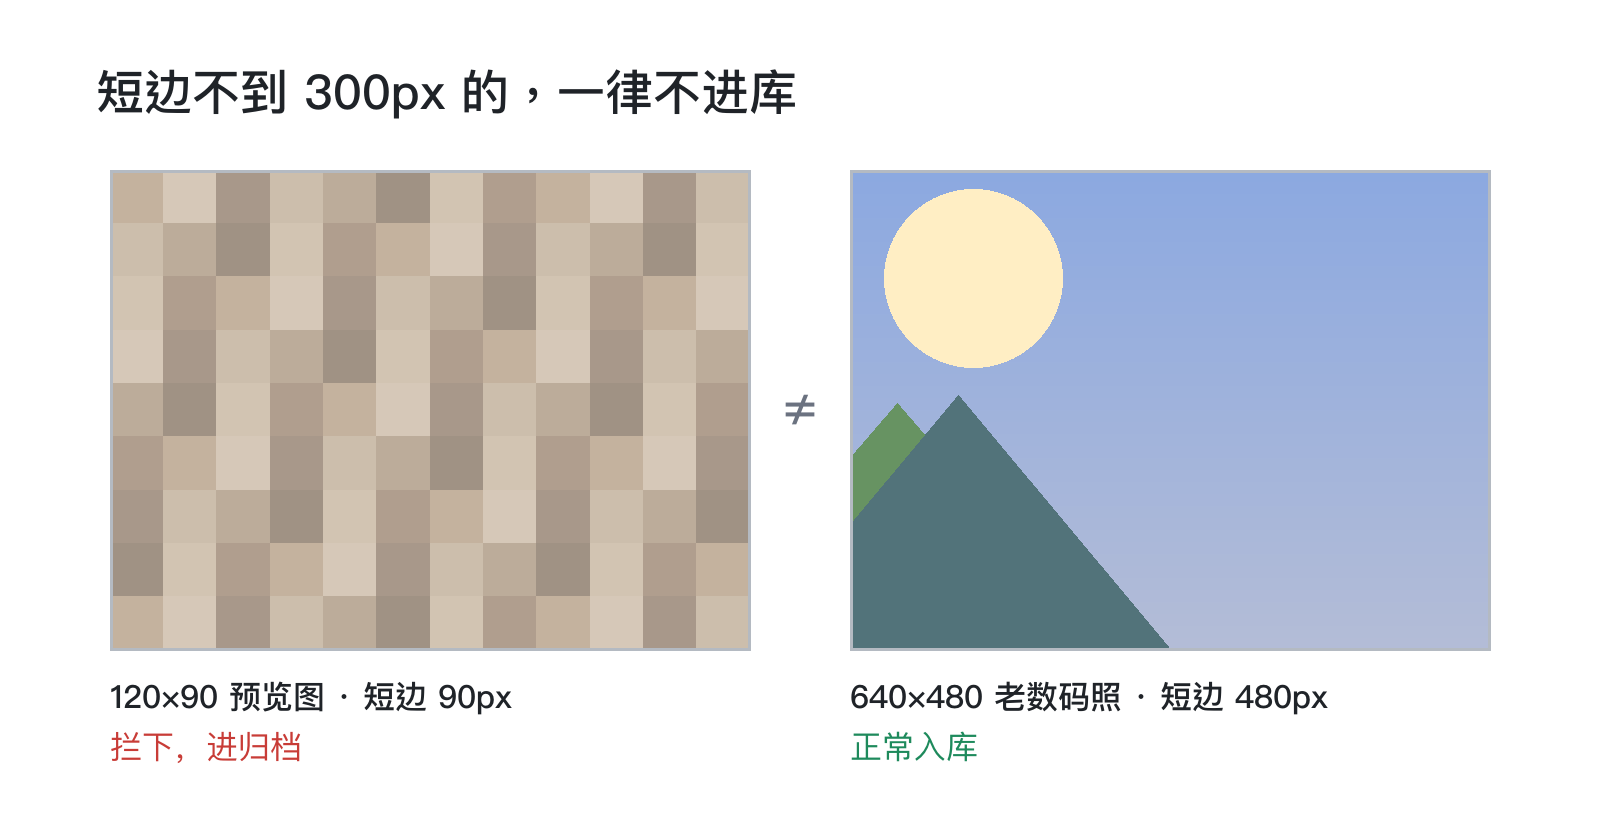
照片的过滤就一条硬标准,短边小于 300px 当缩略图,不进库,这类基本是相册软件的预览图、Windows 缓存、UUID 碎片,一次清出去 238 张,其中 222 张来自同一场婚礼的影楼交付。别想着拿体积判断,比如小于 30KB 就扔,640×480 的老数码照可能只有几十 KB,但它是正经拍摄件。
拦的和放的行,差别大概是这样:
四万条
到最后库里是 43,725 条,409.7 GB,940 个拍摄日,前后跨了二十多年。照片 40,868,视频 2,857。
有 GPS 的只有 15,945 条,剩下三分之二全靠推断,反查用的 Nominatim,1.1 秒一个点,跑完缓存下来 426 KB,回填顺序是 GPS 地址、同日多数或最近、邻日 ±1 到 3 天,最后手动。推断必须留痕,每条都写 地点来源 和 地点置信度,我不想以后自己骗自己。
还有个尴尬的发现,有一批照片的 GPS 最后一段是假的,连着 10 张坐标一模一样,是缓存没刷新。所以那一场的水印只写了”城市 · 区”,门牌没好意思写。
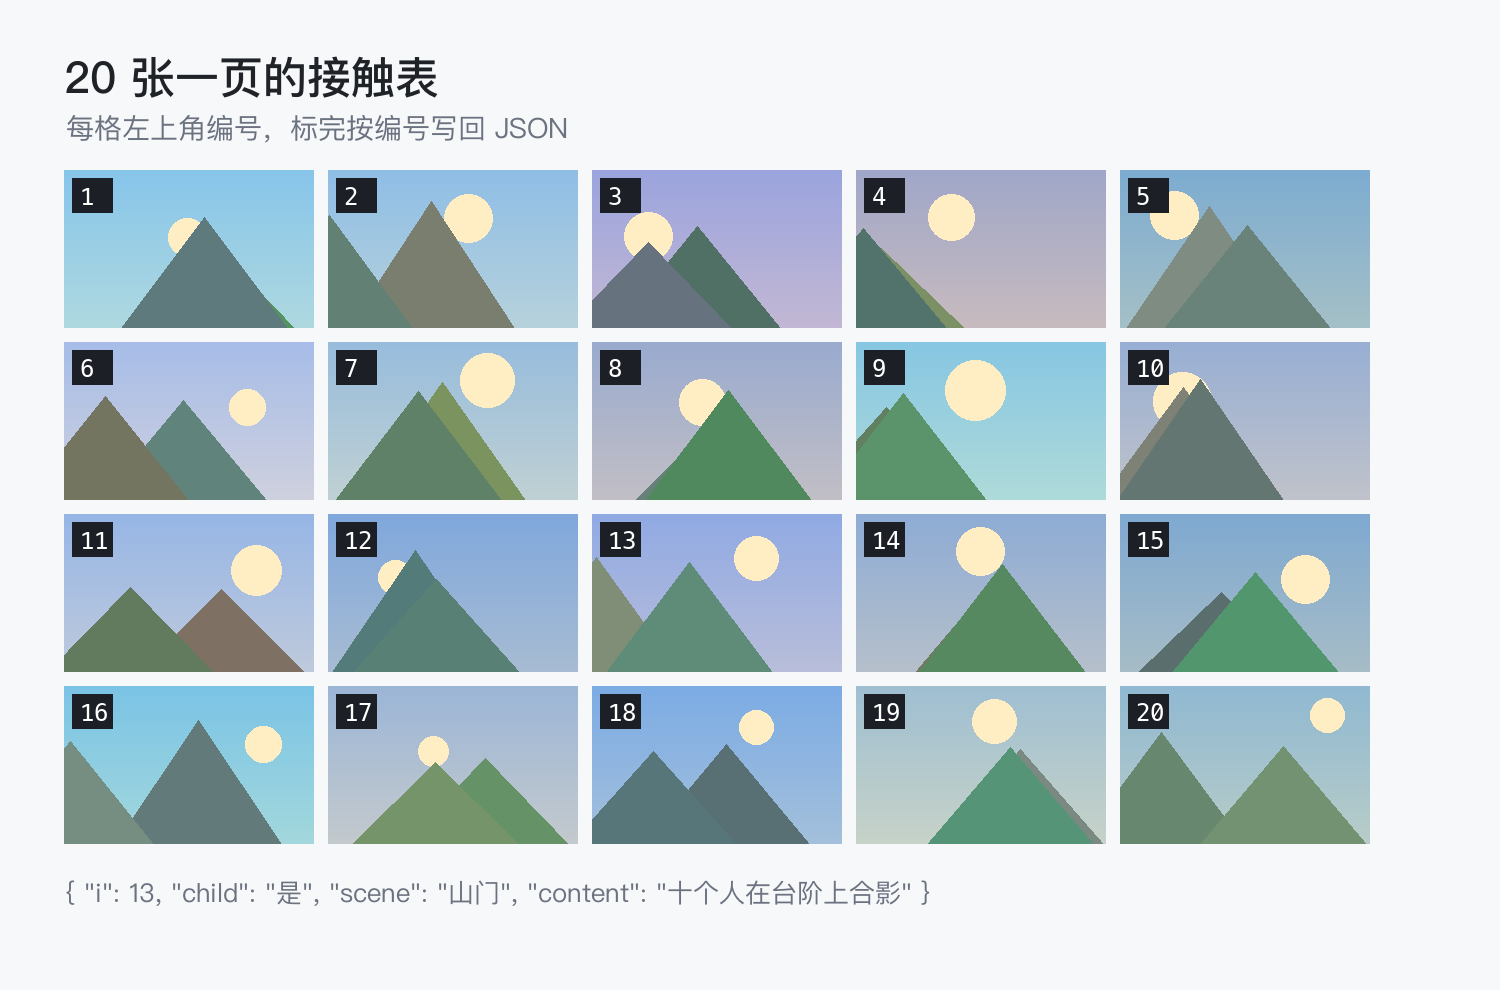
照片的元数据没法全自动,画面里是谁、在干嘛,机器给不出人话。这块的做法是把图变成一次能看完的样子,再逐页标:320px 缩略图,20 张一页的接触表,一页配一个 JSON,标完按编号回填,86 页看完 1,715 张。好处是能重跑,标注原文按页存着,合并脚本随时重来,不用重新看图。
一页长这样:
认人
选片最怕的不是没素材,是说不清”这张里有没有我们自己人”,四万张一张张翻,翻到明年也翻不完。
认脸
用 macOS 的 Vision 本地跑检测,不联网,每张脸给 128 维特征再聚成簇,现在库里 107 簇、7 个身份、1,077 条参考,识别走余弦距离 top-5,阈值 0.64,边距 0.05。
这两个数是被逼出来的:家里人长得太像,身份质心最近的一对只有 0.784。阈值一旦放到 0.50,堂表亲就会被认成同一个人;放到 0.64 之后宁可标”疑似”,也不硬认。
跨年份还得更保守,有一趟更早的旅行,比参考脸还早五六年,人都年轻一截,同一批照片能检出 667 张脸,0.55 的阈值只认出 128 张。所以那趟认出来只拿来加权选片,片子里一个名字都没打,就当”那年春节这些人”。
有些照片不碰
孩子出生前的老照片,我一律没做人脸识别,直接标”无”。那批里全是二十年前的同学、同事,还有一堆现在叫不上名字的人,把他们卷进来没什么意义,也像是替别人做主。
分集
作品集不是按年份分的,是按”一次出行”分的,连续日期的同一次旅行合并,同一个地方隔半年算两趟,婚礼、婚纱、出生、周岁这类单独留。
聚合靠一个 album() 函数硬猜,看来源文件夹和拍摄日期,猜不动的再手工加一条:
|
|
66 个集、21,748 个软链接、0 坏链,就是这么猜出来的。
也撤过集,有个主题乐园的集,40 个文件里只有 18 个真在园区,剩下是截图、洗车、隔壁商场,按”不要硬凑”整集删了。我宁可少一个集,也不想多一个错的。
还有个隐藏的坑,有 32 条素材的来源文件夹名字里带着日期,可实际是第二天拍的,按目录名归档就会错一天,只能拿 EXIF 和文件名对齐。
剪片
每支片子的分析目录里,脚本是这么排的:盘点、画质、去重、人脸、认人、接触表、定稿、校验、音乐、渲染。前面几个都在把素材变成能判断的表,锐度、亮度、人脸数、簇号、是不是代表帧。
选片
真正拍板的是 定稿.py,手写镜头顺序,补上水印文案、推拉焦点、竖构图标记,出一个 镜头表.json,然后 校验.py 管四件事:时间非递减(片头和 preview 除外)、有自己人的镜头占比、每章都有镜头、总长和配乐对得上。
时长也是定死的,合照 3.8 秒,风景 2.2 到 2.8 秒,三张脸以上的合照一张不落。看着机械,但一支三分钟的片子有 50 到 80 个镜头,靠感觉真分不平。
去重到这一步还要再降一档,dHash 只在 ±2 分钟内比,连拍和重复导出并成一簇,一簇留一张代表。影楼那 750 个文件就是这么并成 256 簇、251 个真实镜头的,六个不同日期的目录,其实是同一天。
渲染
渲染是 1920×1080 / 30p,横图满屏加 Ken Burns 推拉 9.5%,竖图走模糊压暗底加完整画幅,转场统一 0.55 秒。竖拍视频带 −90°、倒拍带 −180°,编码宽高却一律 1920×1080,只看宽高会把竖片全当横片。还有一段 24 分钟的游船被 4GB 上限切成三个文件,镜头表得按入点跨章取。
水印定了全局标准,日期 55px、地点 48px,只写 YYYY.MM.DD 和一个短地名。位置按右下、左下、左上、右上试,用 Vision 的人脸框外扩 20px 判断,四个角都压到脸才选重叠最小的,记一个 forced=true。不写时分是因为同一场落日三台设备能差四个多小时,同一个时刻能标出三个钟点,只标日期就没这个矛盾了。
避让的逻辑大概是这么回事:
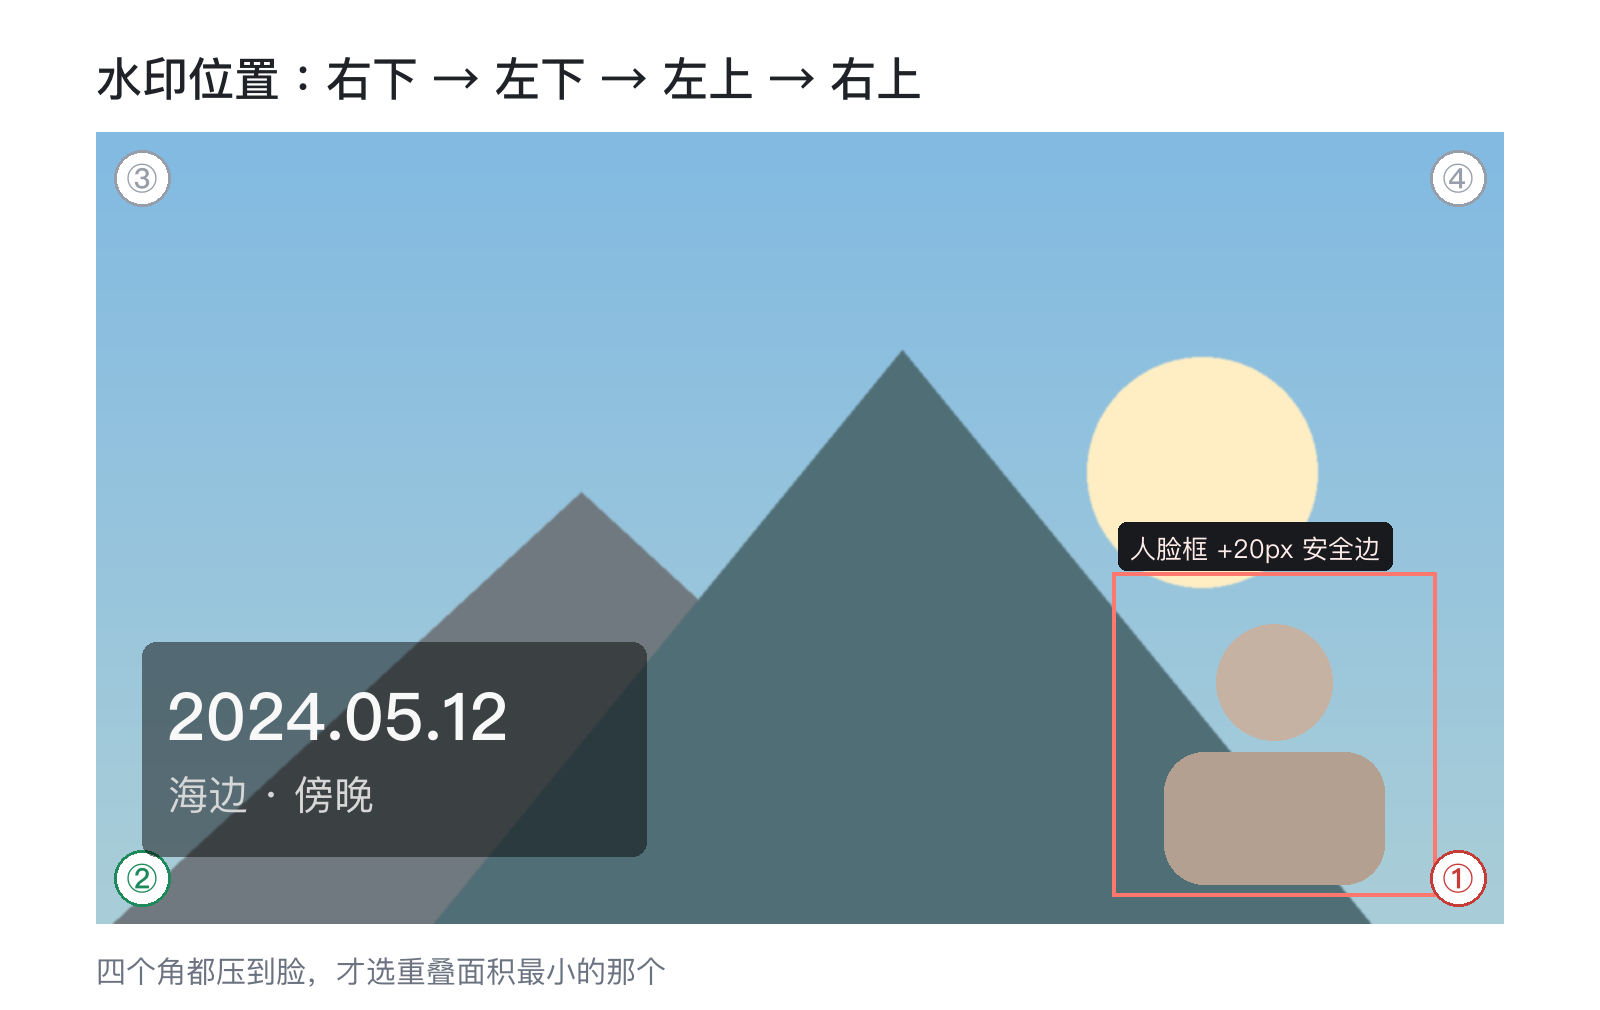
|
|
配乐和封面
配乐从程序生成换成了授权曲库。挑的依据不是标题,是频谱重心和速度,这批里只有一首是真钢琴,重心 379 Hz,没鼓点。用的时候也不循环,曲长 140.46 秒,片子 140.65 秒,直接吃它自己的收尾,补 0.2 秒静音,整体 loudnorm 到 −16 LUFS。
封面是最容易翻车的一公里。mp4 里能写 attached_pic 和 covr,Finder、QuickTime 都认,可朋友圈抓的是首帧。第一版片头是黑底卡加 1 秒淡入,分享出去就是一张纯黑的图。后来改成第一帧就是画面,淡入设 0,九支片子的首帧亮度从 0–17 提到 62–244,一支一支量的。
还没弄完
人脸识别只能跑 macOS,Vision 加 PyObjC,换台 Windows 就哑了;视频的内容描述还是半人工,2,857 段没逐条校对过;十年以上的老照片地点基本靠人认,没 GPS 也没法反查;-c copy 拼片会出现重复 DTS,解码器直接报 non monotonically increasing dts,拼完必须过一遍 -r 30 -fps_mode cfr 重编码。
另外还有一趟旅行、一支三年回忆、七段地点片没出片,慢慢来吧。
花了多少钱
顺便记一笔账。
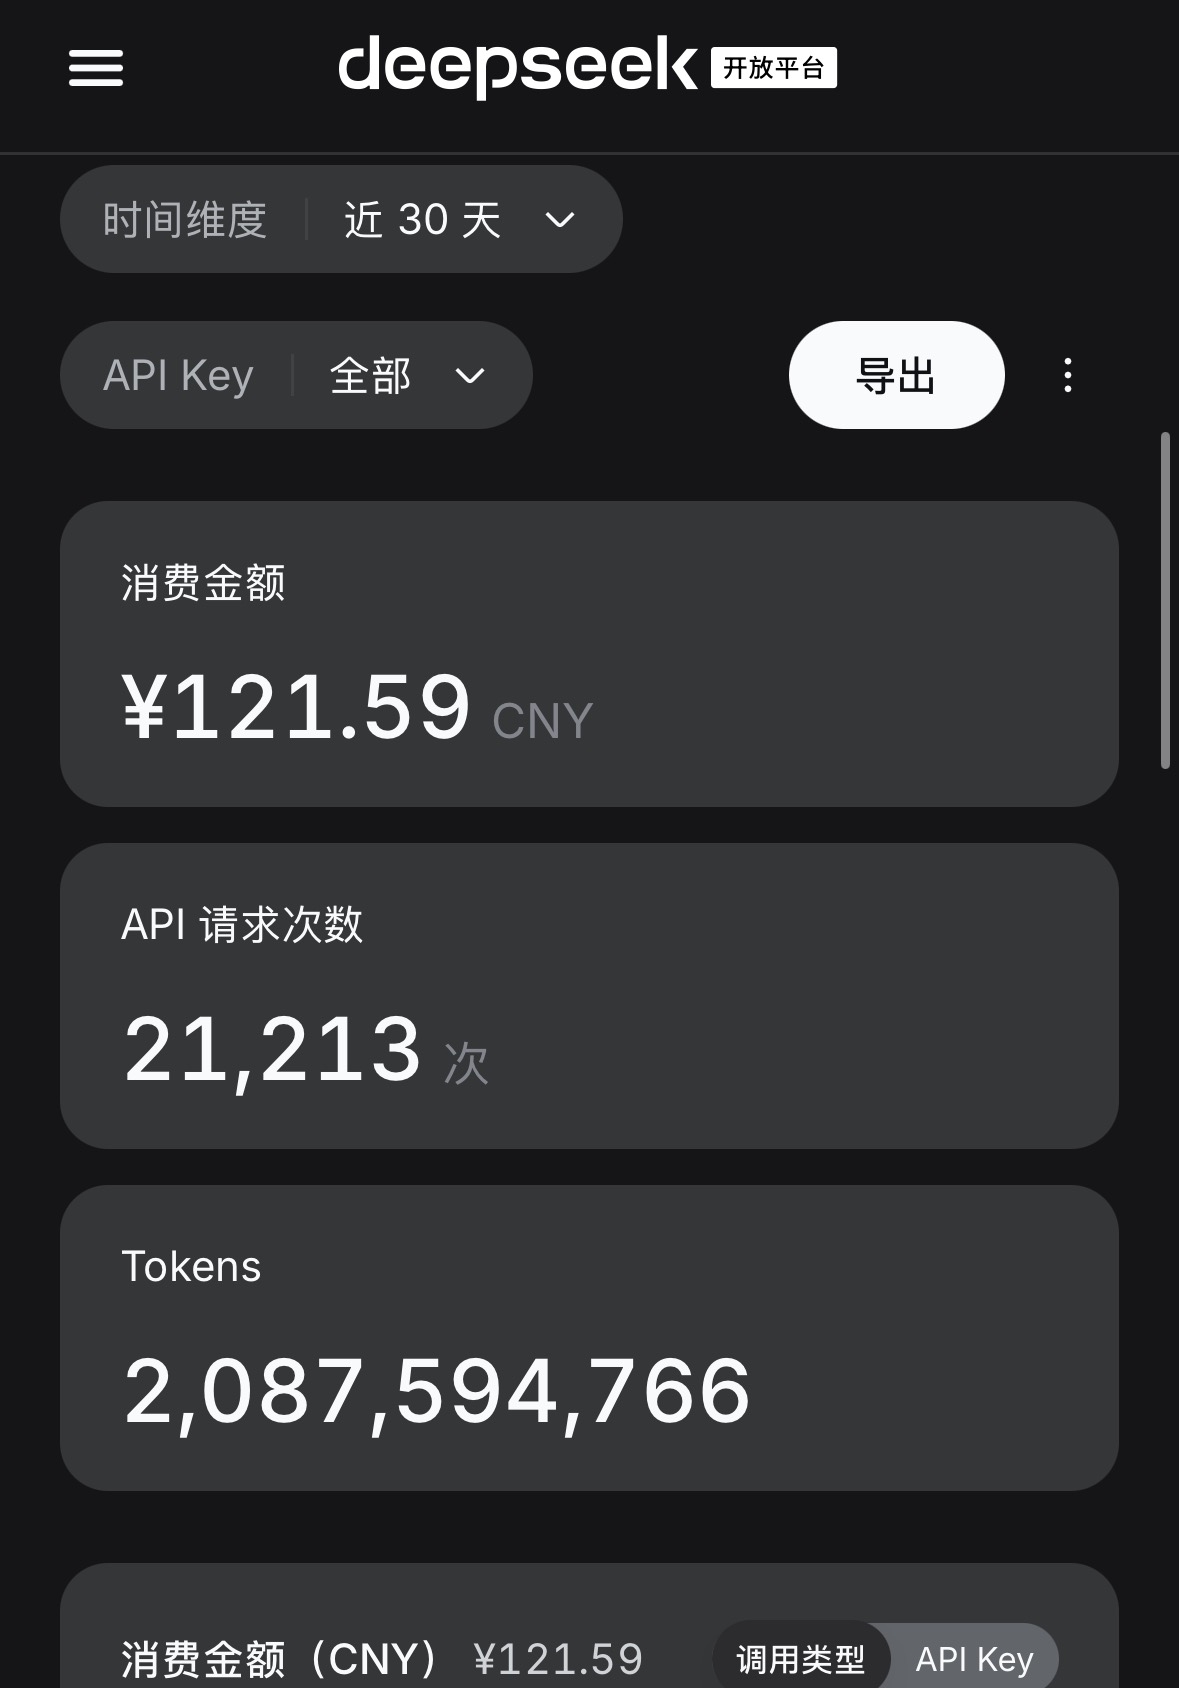
这一个月,给照片写描述、补索引、来回改提示词,模型一共被调了 21,213 次,烧掉 2,087,594,766 个 token,账单 121.59。
摊到四万三千多条素材上,一条不到一分钱,比我估的便宜不少。真让我自己把这四万张看一遍,一个月不够,眼睛也先受不了。
看到那个二十亿会愣一下,换算成钱又觉得还好,一顿饭的事。
这些片子背后其实是一堆表、一堆脚本和一堆被推翻的假设。不过看的人不需要知道,我自己记得就行。